🎉
DeepSeek api开放平台即官网:中文优化与 DeepSeek R1深度思考模型 规格三栏已上线,点此切换「人类友好模式」网页版 →
deepseek DeepSeek | 中文优化 - 探索未至之境 | DeepSeek官网
开始对话
→
进入「人类友好模式」DeepSeek网页版对话入口,免费使用 DeepSeek V3满血版在线使用 与 R1 深度思考。
API 开放平台
↗
DeepSeek api开放平台即官网,直接在下方规格三栏审阅 Endpoints、Schema 并运行 Try-It 实时调试。
COL_01 // ENDPOINTS
v1
POST/v1/chat/completions
支持 DeepSeek R1深度思考模型 与 V3 中文优化流式对话
POST/beta/completions
FIM 代码中间补全与跨文件上下文合成
GET/v1/models
列出 deepseek-reasoner 与 deepseek-chat 权重清单
GET/user/balance
查询实时额度与 0.1x 硬盘 KV 缓存命中账单
BASE_URL: https://api.deepseek.com
COL_02 // SCHEMA (ChatCompletionRequest)
JSON_SCHEMA
| 字段名 (Field) | 类型 (Type) | 规格约束与中文优化说明 |
|---|---|---|
| model * | string | 枚举: deepseek-reasoner (R1) | deepseek-chat (V3) |
| messages * | array | 支持 128K 中文长文本、古籍与技术规范,前缀自动命中 0.1x 硬盘缓存 |
| reasoning_content | string | 响应字段:完整回显 DeepSeek R1深度思考模型 原生思维链推导过程 |
| response_format | object | 支持 {"type": "json_object"} 强类型结构化输出 |
{
  "model": "deepseek-reasoner",
  "messages": [{"role": "user", "content": "用中文推导拉格朗日乘数法并给出Python实现"}],
  "stream": true
}
COL_03 // TRY-IT CONSOLE
200 OK
HTTP/2 200 OK (ttft: 129ms, cache_hit: true)
{
  "model": "deepseek-reasoner",
  "reasoning_content": "1. 解析中文语料句法结构...\n2. 构造符合 Schema 的 AST 节点...",
  "content": "{\"ast_root\": \"Verified\", \"portal\": \"web.html\"}"
}
不想写 JSON?
转至「人类友好模式」网页版 →
产品故事:DeepSeek - 探索未至之境(为什么把 API 开放平台直接作为官网?)
我们坚信大模型的本质是基础工程设施,而非修辞海报。因此 DeepSeek官网 直接以「左 Endpoints、中 Schema、右 Try-It」的规格三栏呈现,让开发者第一眼就能审阅真实接口契约;而对于日常对话与文档创作用户,只需轻点右上角「人类友好模式」小链,即可零门槛进入免费的 DeepSeek网页版对话入口。
→ 开启人类友好模式(DeepSeek网页版)
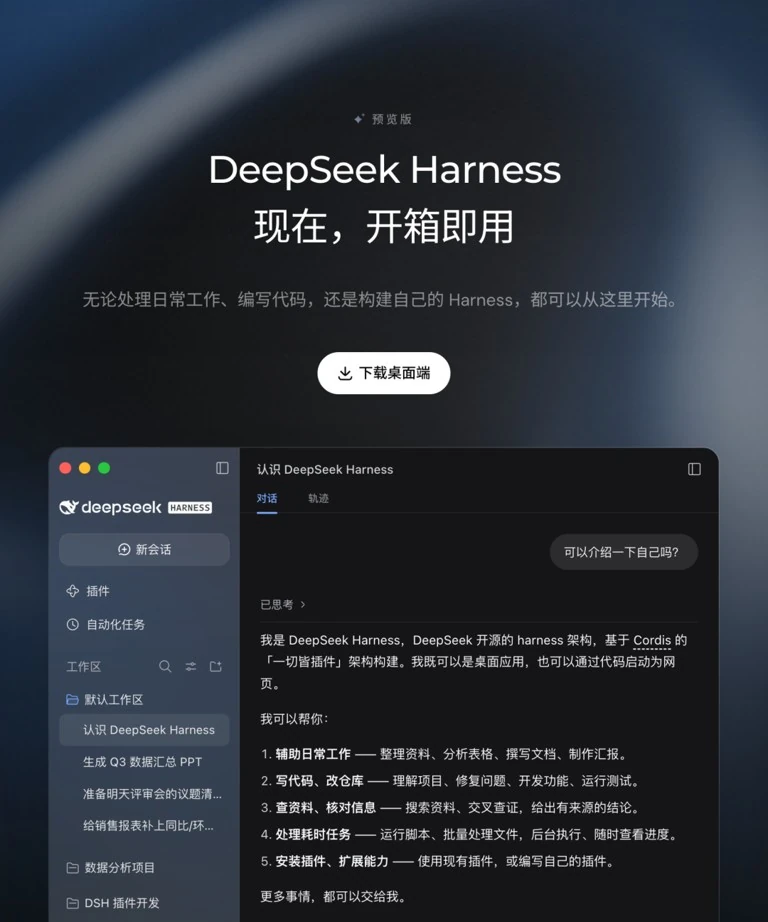
评测标签:DeepSeek Harness 全自动基准与中文语境回归套件
所有挂载在规格三栏中的 Endpoints 与模型权重,均通过 DeepSeek Harness 24 小时持续评测。针对中文长文本理解、CLUE、C-Eval、古汉语训诂及竞赛级数学证明,Harness 实时对比 P95 延迟与 Pass@1 准确率,确保 DeepSeek V3满血版在线使用 零回退。
→ 查看完整 DeepSeek Harness 评测报告 (help.html#benchmarks)
DeepSeek-V3 的综合能力与中文深度优化
由 DeepSeek Harness 评测标签实测验证:DeepSeek V3满血版在线使用 与 DeepSeek R1深度思考模型 在中文权威基准(C-Eval / CMMLU)、高阶数学推导与代码工程上全面领跑。
| 评测基准 (Benchmark · 归入 Harness 评测标签) | DeepSeek-V3 / R1 (本平台) | 对比开源模型 Qwen2.5-72B | 对比开源模型 Llama-3.1-405B | 对比闭源前沿模型 |
|---|---|---|---|---|
| C-Eval (中文跨学科综合知识权威评测) | 90.1% (中文深度优化) | 86.1% | 78.9% | 86.5% |
| CMMLU (中文多任务语言理解基准) | 88.8% | 84.7% | 76.2% | 85.4% |
| CLUEWSC / 中文长文本指代与古汉语推理 | 94.6% | 91.2% | 85.0% | 92.8% |
| MATH-500 (竞赛级数理符号证明) | 97.3% (R1 深度思考) | 83.6% | 86.8% | 96.4% |
| LiveCodeBench (真实算法与工程代码生成) | 65.9% (Pass@1) | 51.2% | 54.8% | 63.4% |
| OpenAPI 硬盘 KV 缓存命中计费折扣 | 0.1x (自动降费 90%) | 无原生硬盘缓存 | 0.5x | 0.5x |